> ## Documentation Index
> Fetch the complete documentation index at: https://typecast.ai/docs/llms.txt
> Use this file to discover all available pages before exploring further.
# n8n
[n8n](https://n8n.io/)은 시각적 워크플로우 자동화 도구입니다. 타입캐스트 노드를 사용하면 코딩 없이 텍스트를 음성으로 자동 변환할 수 있습니다!
## 활용 방안
타입캐스트 n8n 노드를 사용하면 다음을 할 수 있습니다:
- **콘텐츠 제작 자동화** - RSS 피드, AI 작성, 타입캐스트 음성을 결합하여 완전 자동화된 YouTube 또는 TikTok 채널 구축
- **고객 경험 향상** - 고객이 구매할 때 WhatsApp 또는 이메일로 개인화된 음성 메시지 전송
- **도달 범위 확대** - 팟캐스트 또는 비디오 콘텐츠를 여러 언어로 자동 번역 및 더빙
- **음성 추천** - 자연어 설명으로 후보 음성을 검색
- **알림 받기** - 중요한 시스템 업데이트 또는 판매 마일스톤에 대해 Slack 또는 Discord에서 맞춤 음성 알림
---
## 사전 준비 사항
시작하기 전에 다음을 준비하세요:
1. **n8n** 설치 ([n8n Cloud](https://n8n.io/) 또는 자체 호스팅)
2. **타입캐스트 API 키** - [여기서 받기](https://studio.typecast.ai/developers/api/)
---
## 설치
### 단계 1: 타입캐스트 노드 설치
n8n Cloud를 사용하는 경우 별도의 설치가 필요 없습니다. **빠른 시작** 섹션으로 바로 건너뛰세요.
노드를 검색할 때 설치 버튼이 나타나면 **Install node**를 클릭하여 설정을 완료하세요.
1. n8n 설치 디렉토리에서 다음 명령을 실행하세요:
```bash
npm install @neosapience/n8n-nodes-typecast
```
2. n8n을 다시 시작하세요.
---
## 빠른 시작: 첫 번째 음성 생성
첫 번째 텍스트 음성 변환 워크플로우를 만들어 보세요.
### 단계 1: 타입캐스트 노드 추가
1. 새 워크플로우 만들기
2. **+** 버튼을 클릭하여 노드 추가
3. **Typecast** 검색
4. **Typecast** 선택
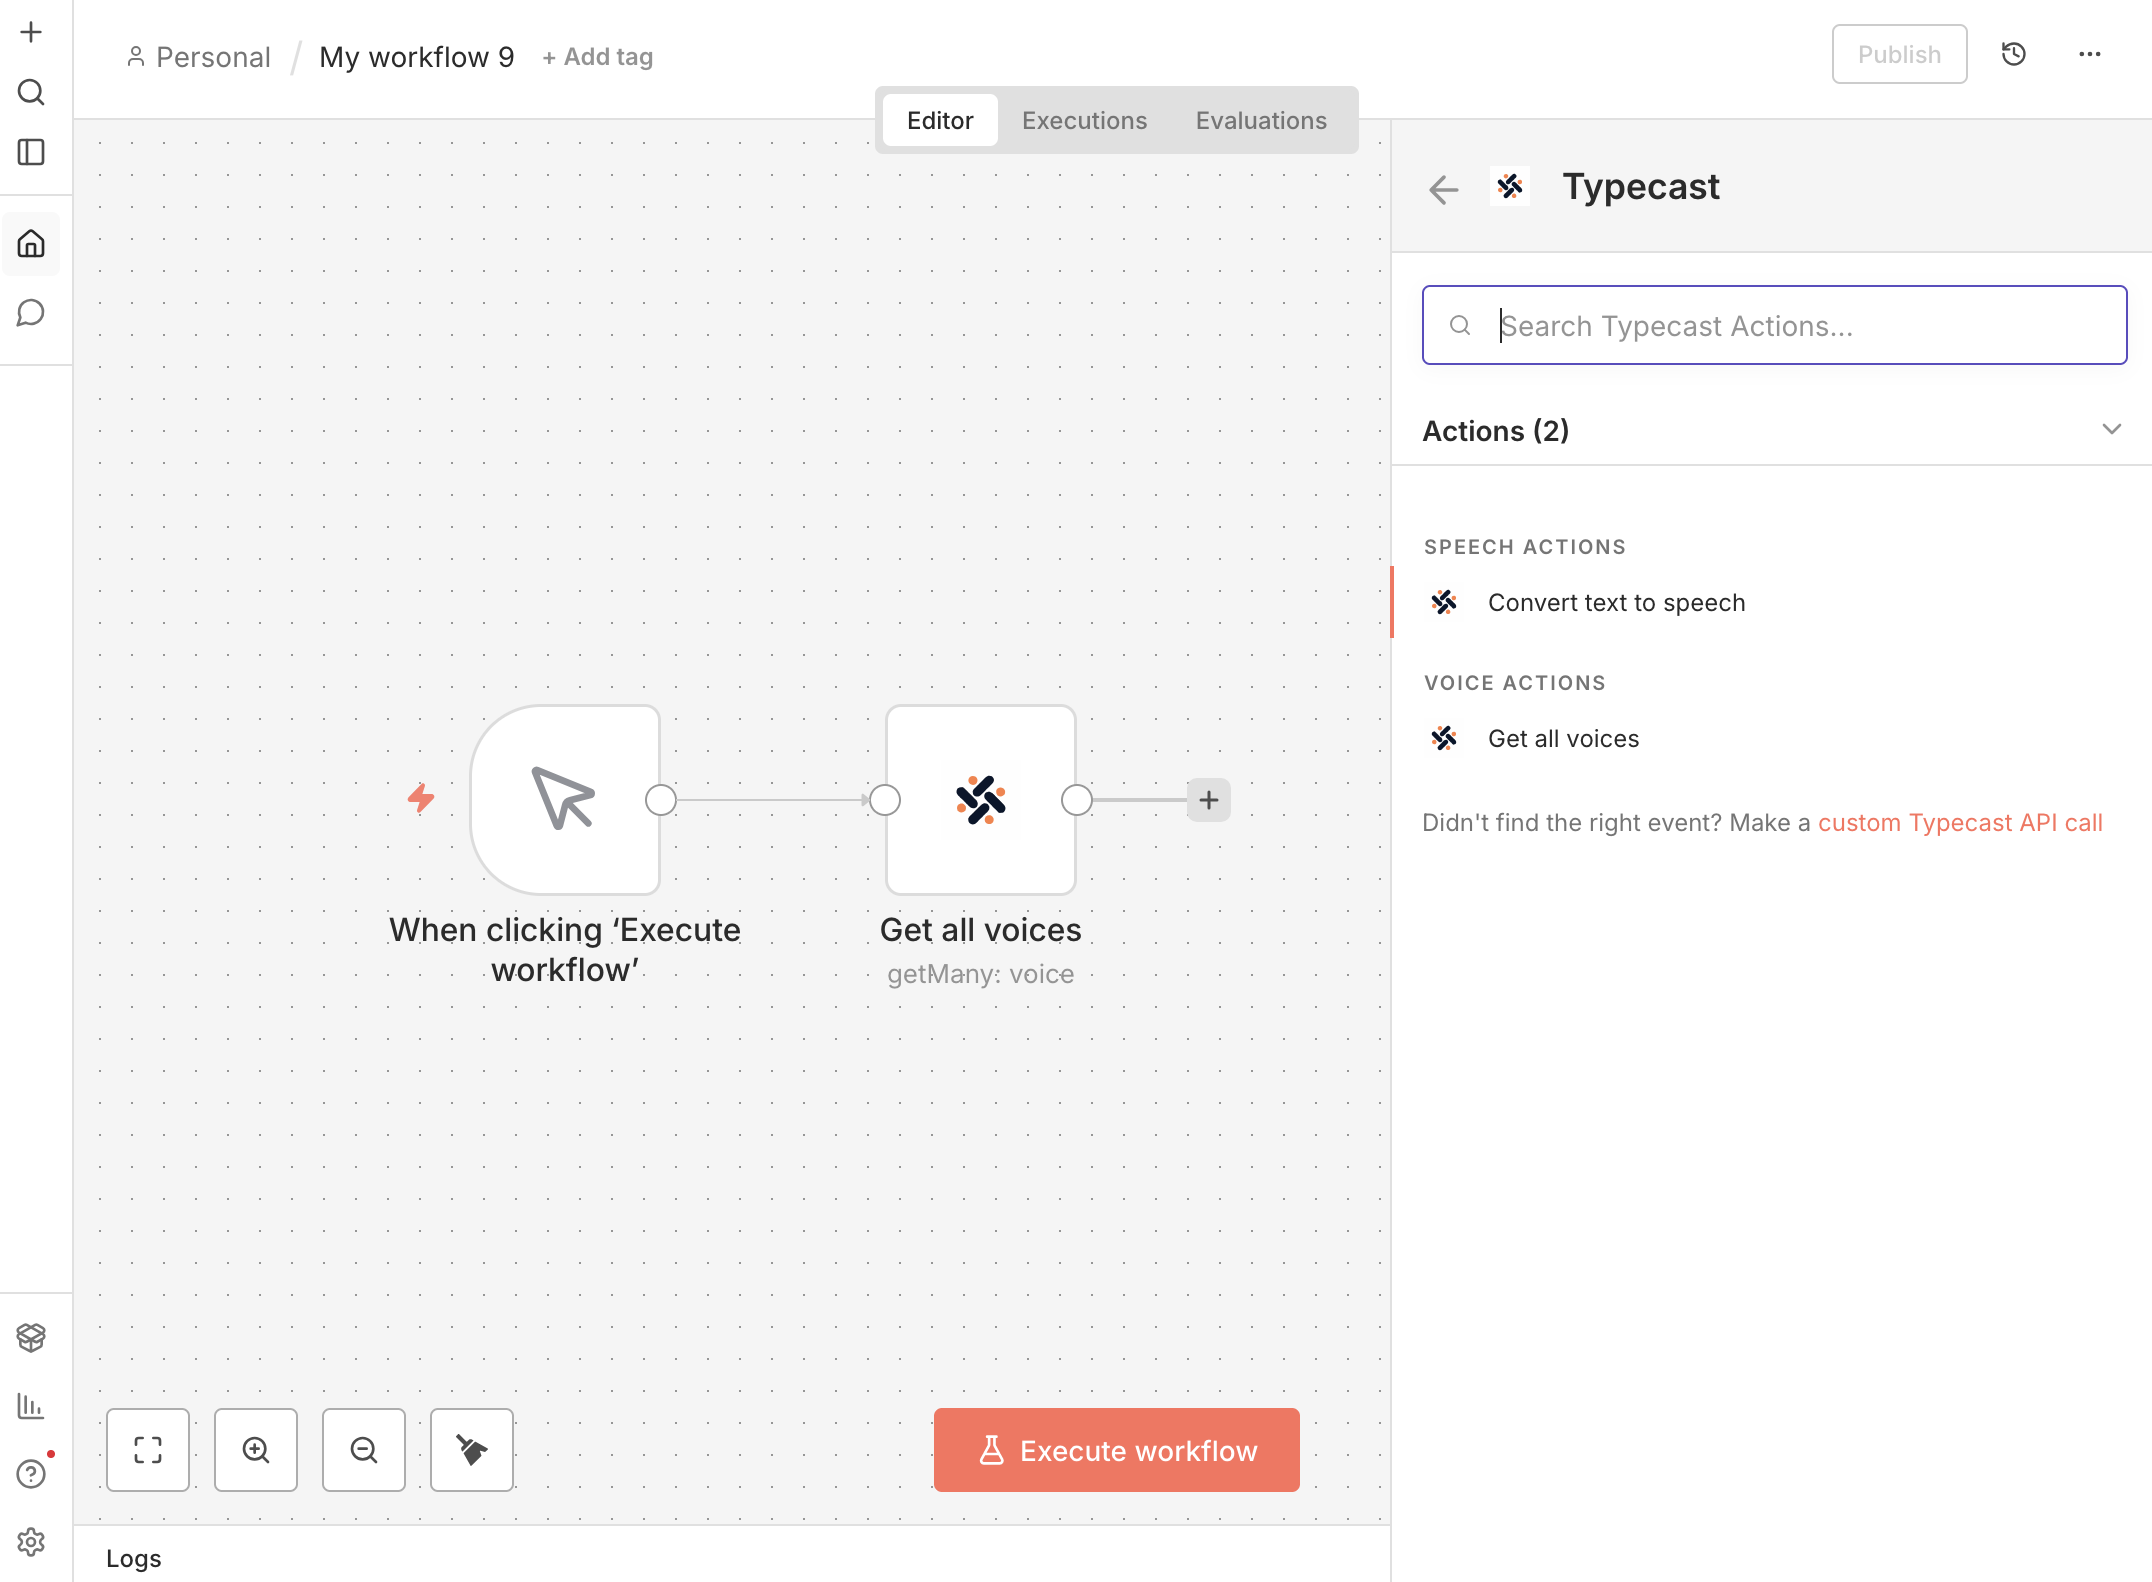
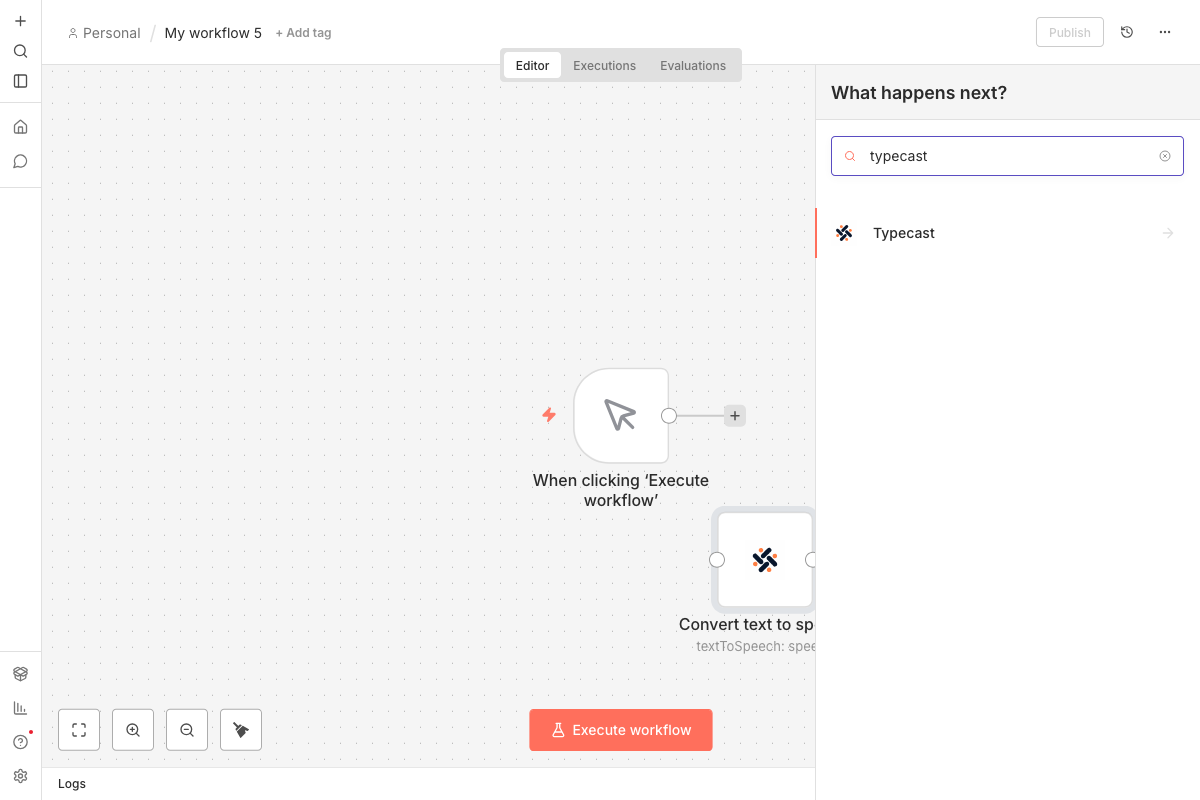 5. 목록에서 액션 선택 (예: **Convert text to speech**)
 ### 단계 2: API 키 연결 (인증 정보)
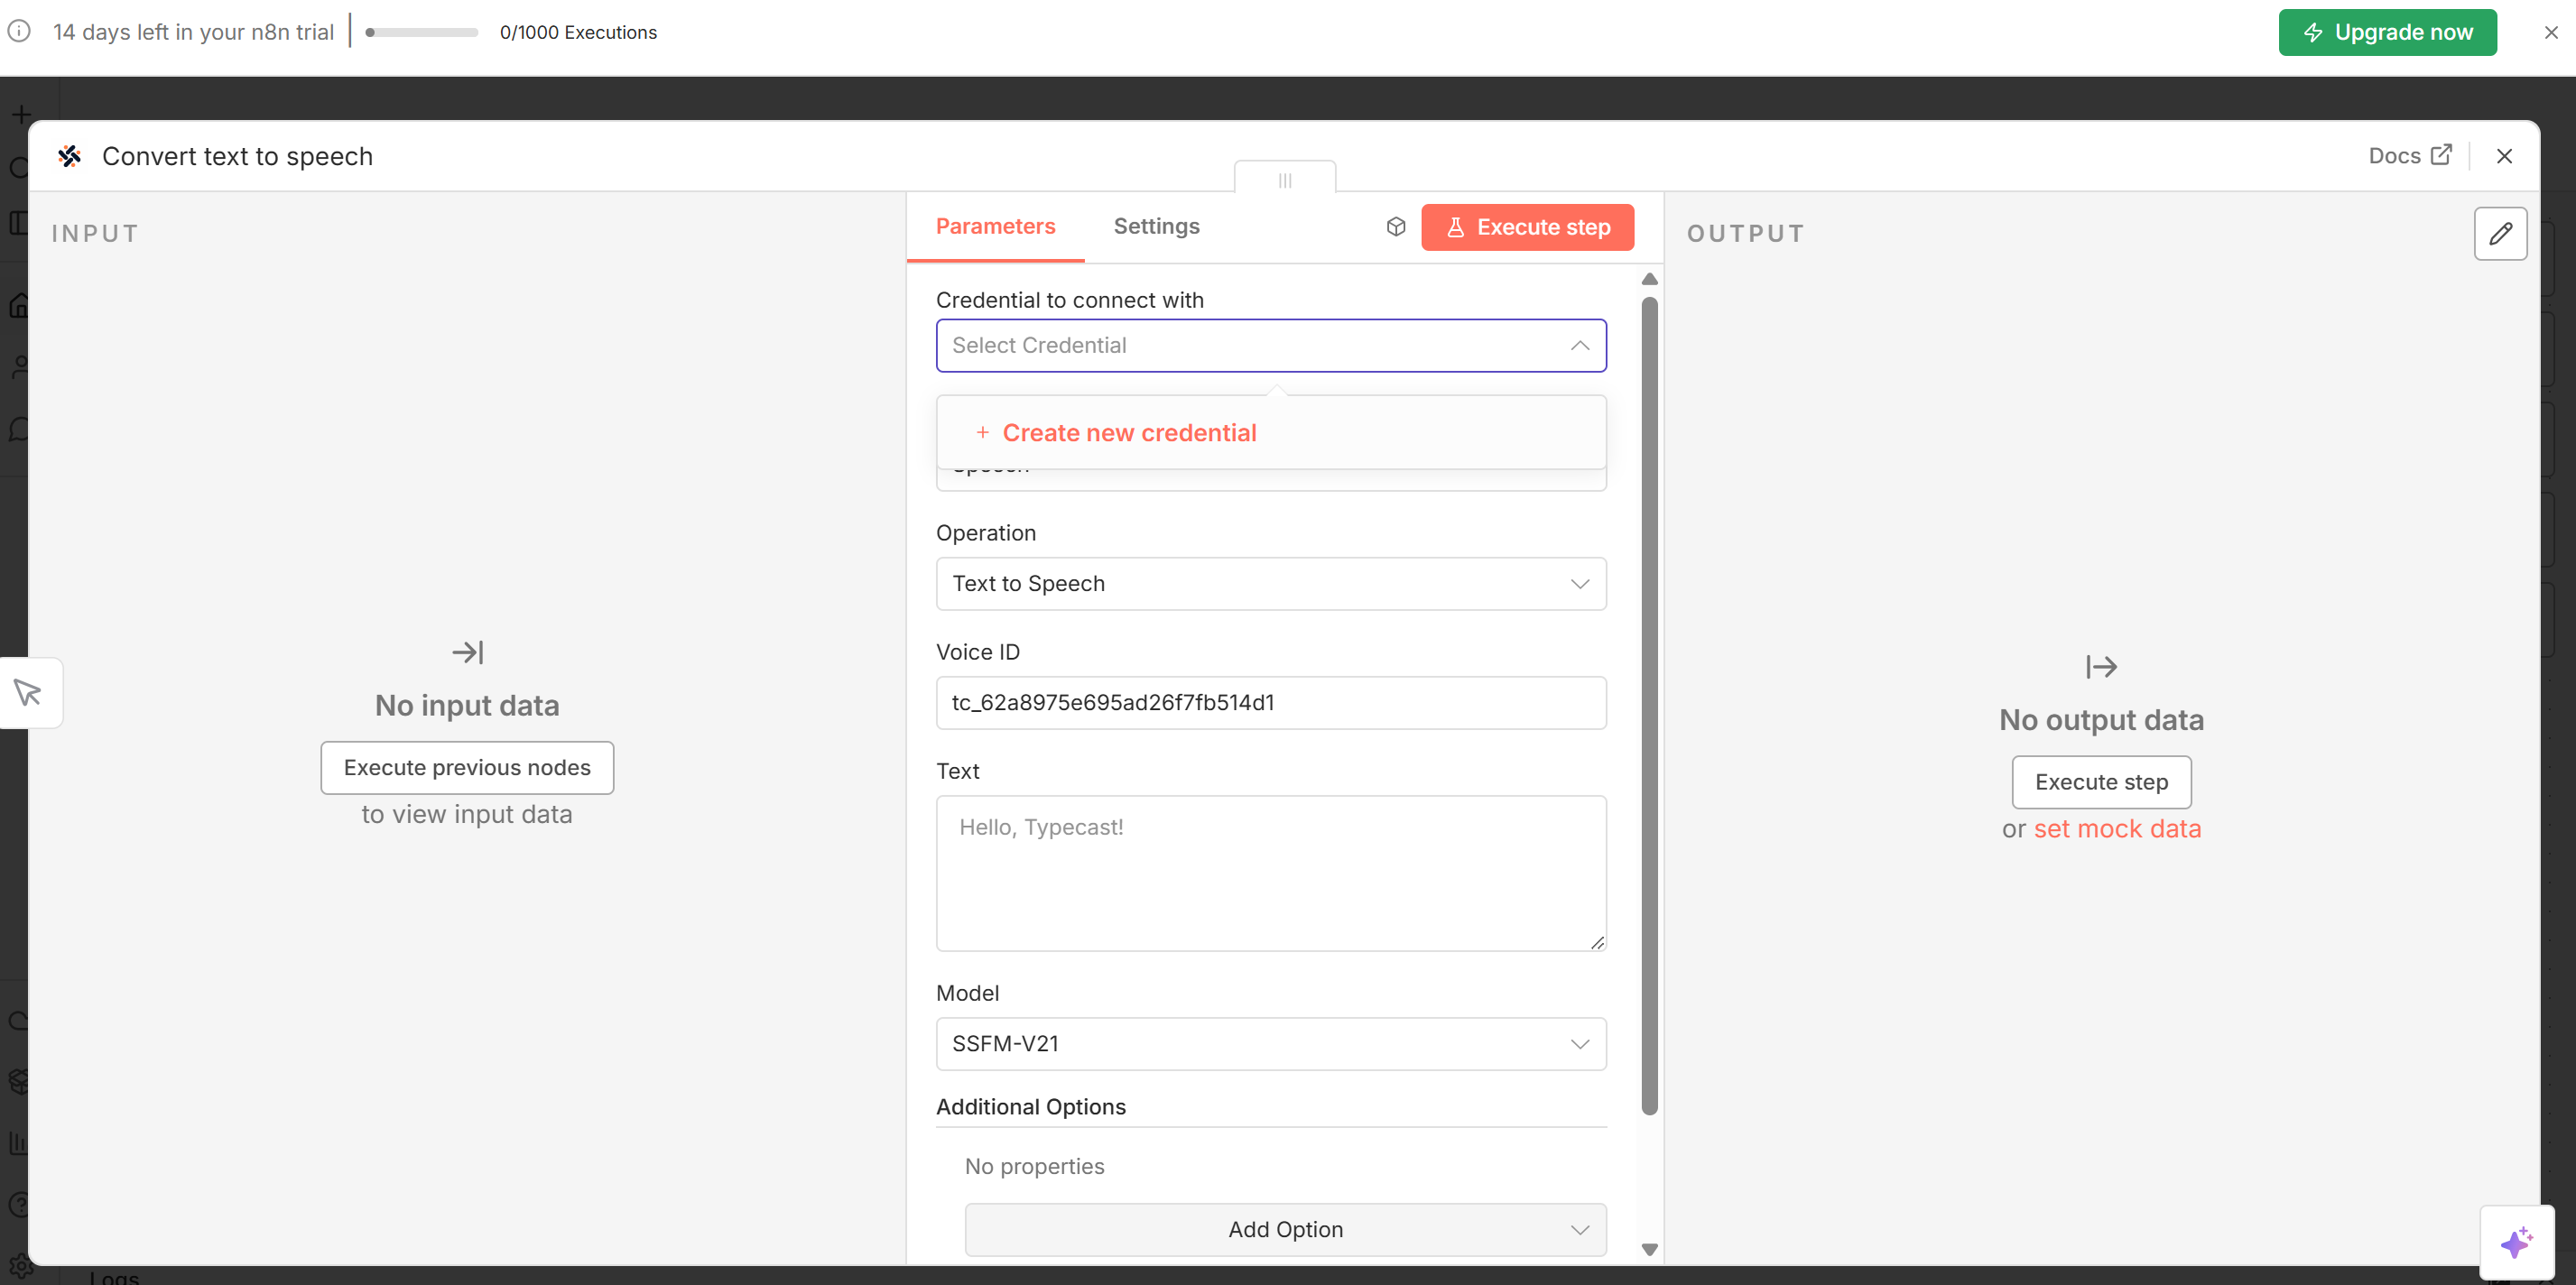
노드를 선택한 후 타입캐스트 API와 연결하기 위해 API 키를 구성해야 합니다.
1. 노드 설정 패널에서 **Credential to connect with** 필드를 클릭하세요.
2. **- Create New Credential -** 항목을 선택하세요.
3. [타입캐스트 API 콘솔](https://studio.typecast.ai/developers/api/)에서 복사할 수 있는 API 키를 입력하세요.
4. **Create**를 클릭하여 자격 증명을 저장하세요.
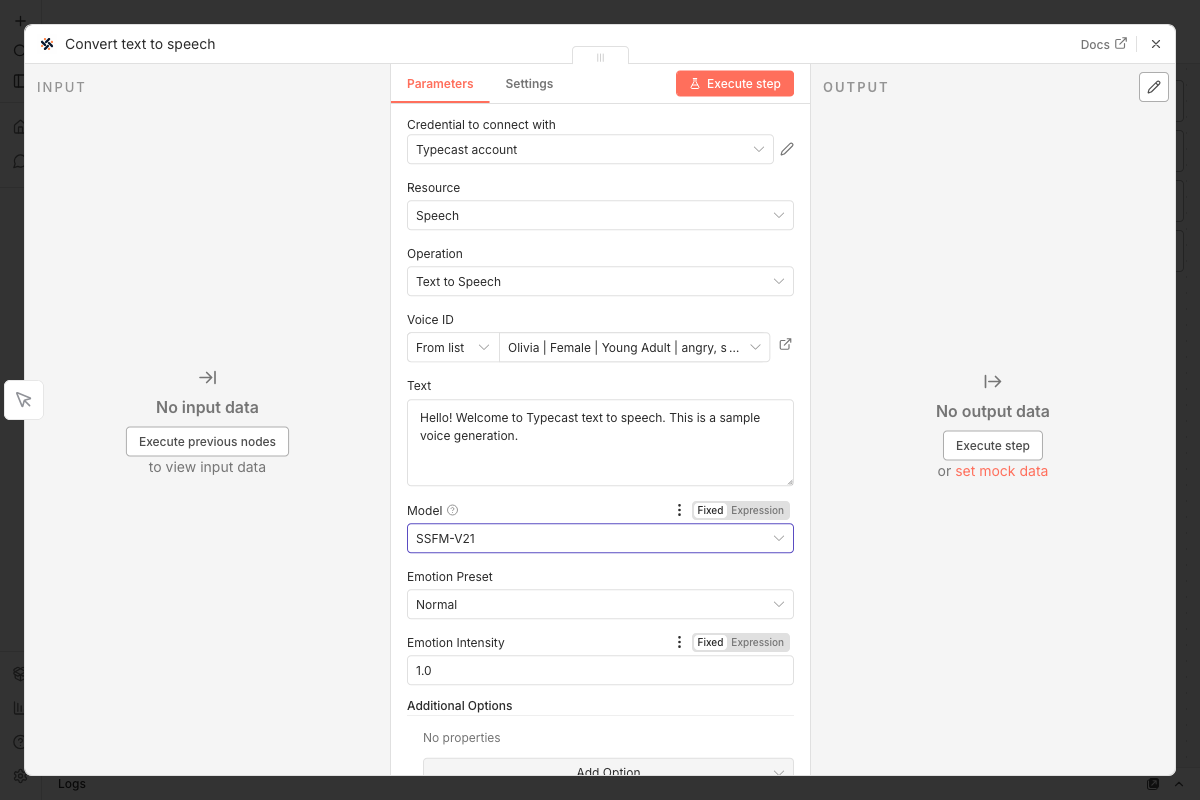
 ### 단계 3: 텍스트 음성 변환 구성
| 설정 | 입력할 내용 |
|---------|---------------|
| **Resource** | `Speech` |
| **Operation** | `Text to Speech` |
| **Voice ID** | 드롭다운에서 음성 선택 (이름, 성별, 나이, 감정 표시) |
| **Text** | 변환할 텍스트 |
| **Model** | `ssfm-v30` - 최고 품질 권장 |
#### 보이스 선택
Voice ID 필드에서 보이스를 쉽게 찾을 수 있습니다:
1. Voice ID 드롭다운을 클릭하세요
2. 세부 정보(이름, 성별, 나이, 사용 가능한 감정)와 함께 보이스 둘러보기
3. 이름이나 특성으로 필터링하는 검색 사용
4. 원하는 보이스 선택
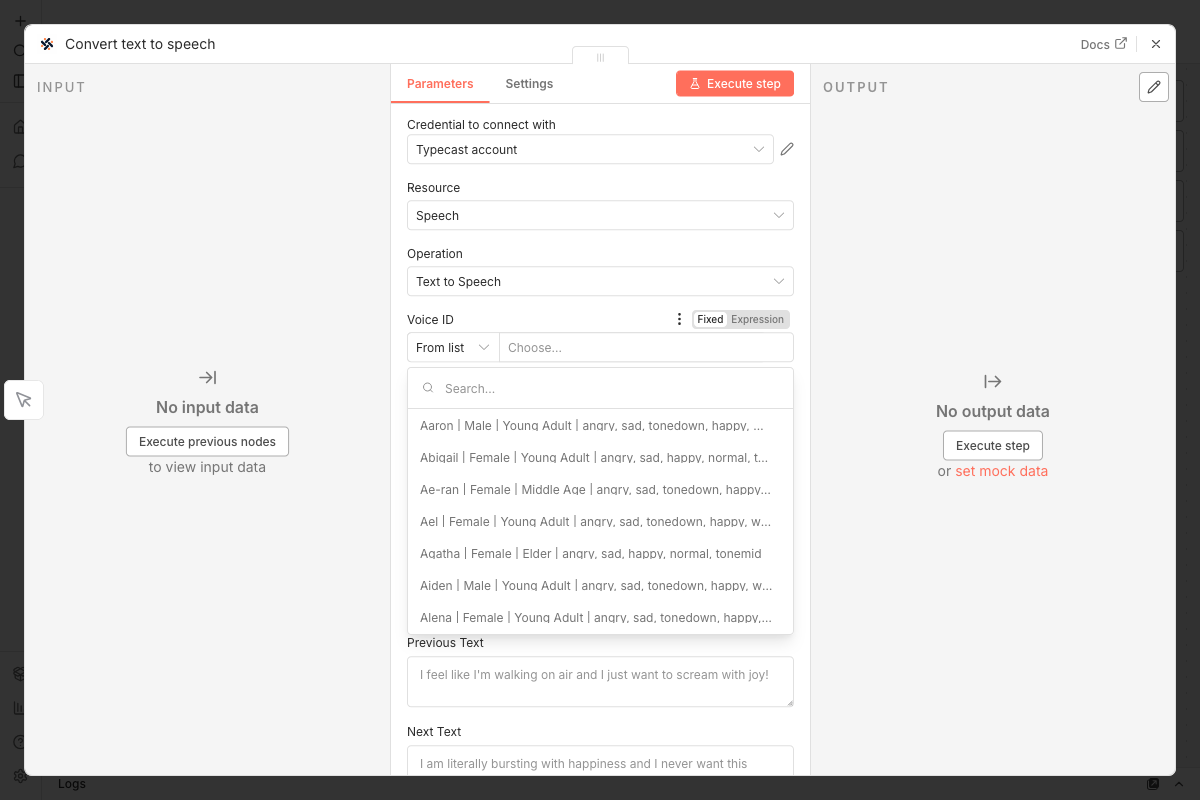 Voice ID를 직접 입력하려면 "By ID" 모드로 전환할 수도 있습니다 (예: `tc_60e5426de8b95f1d3000d7b5`).
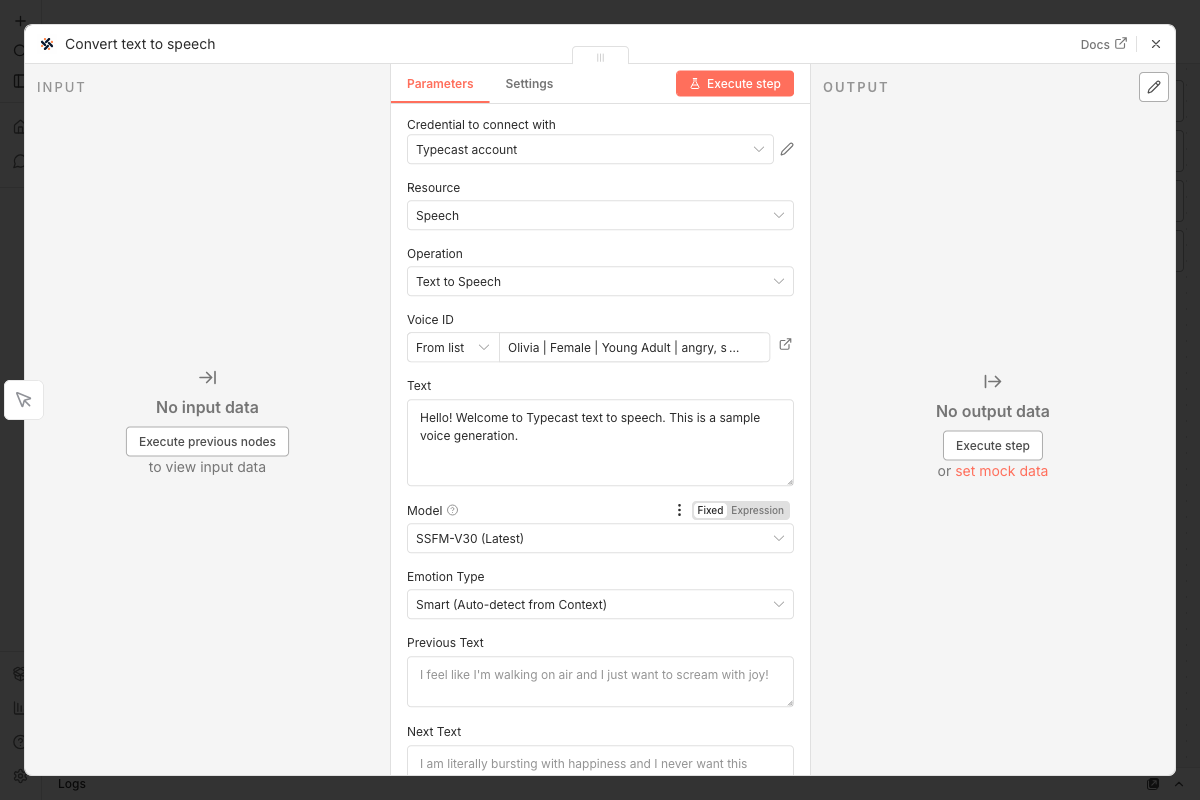 #### 감정 설정
감정 조절로 음성을 표현력 있게 만드세요!
**ssfm-v30용**
감정을 추가하는 두 가지 방법:
AI가 텍스트 맥락에서 최적의 감정을 자동으로 감지합니다. 자연스러운 대화와 스토리텔링에 적합합니다.
7가지 감정 중에서 수동으로 선택합니다: Normal, Happy, Sad, Angry, Whisper, Tone Up, Tone Down.
**스마트 이모션 팁:** AI가 맥락을 더 잘 이해하도록 "Previous Text"와 "Next Text"를 추가하세요!
**ssfm-v21용**
4가지 감정 중에서 선택: `Normal`, `Happy`, `Sad`, `Angry`
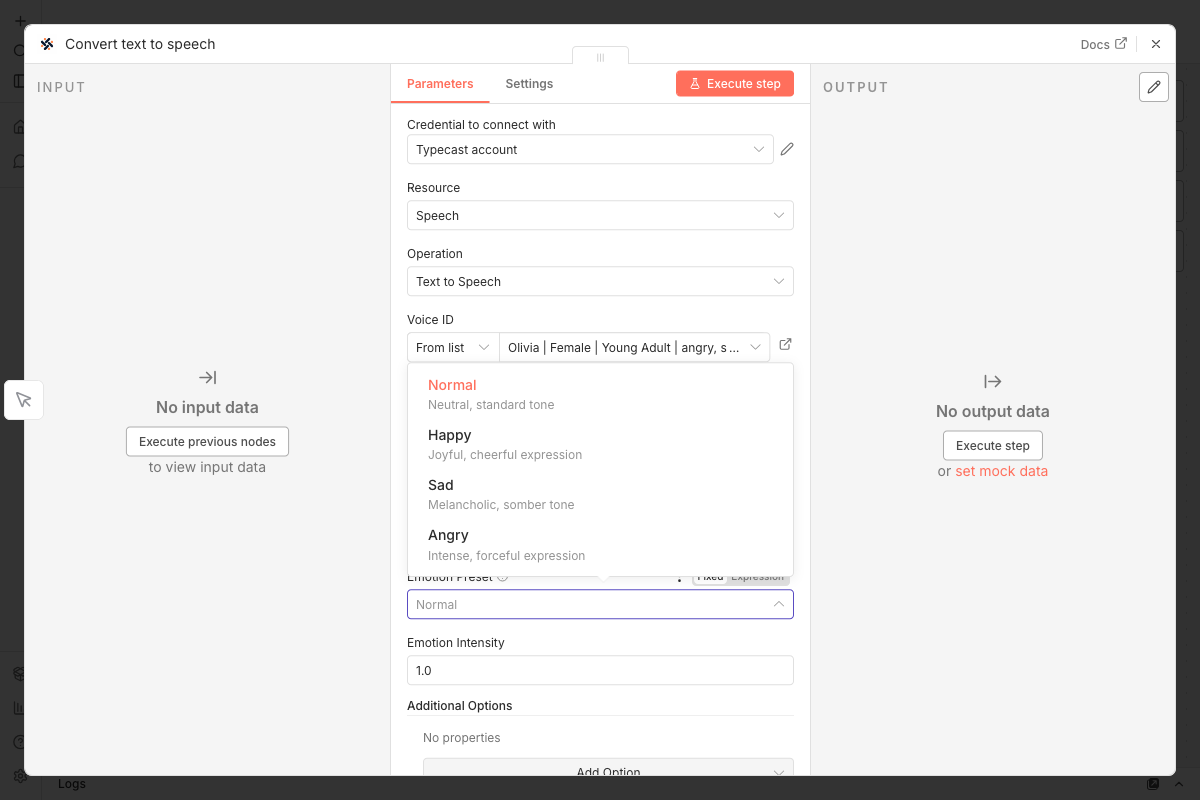 **Emotion Intensity** (0.0 - 2.0) 조절:
- `0.0` - 낮은 강도
- `1.0` - 표준 (기본값)
- `2.0` - 최대 강도
 #### 추가 옵션
오디오 출력 사용자 정의:
| 옵션 | 설명 | 기본값 |
|--------|-------------|---------|
| **Audio Format** | `WAV` (고품질) 또는 `MP3` (작은 크기) | WAV |
| **Audio Pitch** | 피치 조절 (-12 ~ +12 반음) | 0 |
| **Audio Tempo** | 속도 조절 (0.5x ~ 2.0x) | 1.0 |
| **Language** | 필요한 경우 자동 감지 재정의 | 자동 감지 |
### 단계 4: 실행 및 듣기
1. 노드 연결 (Manual Trigger → Typecast)
2. **Execute Workflow** 클릭
3. 출력 확인 - 오디오 파일이 준비되었습니다!
4. 오디오를 클릭하여 재생
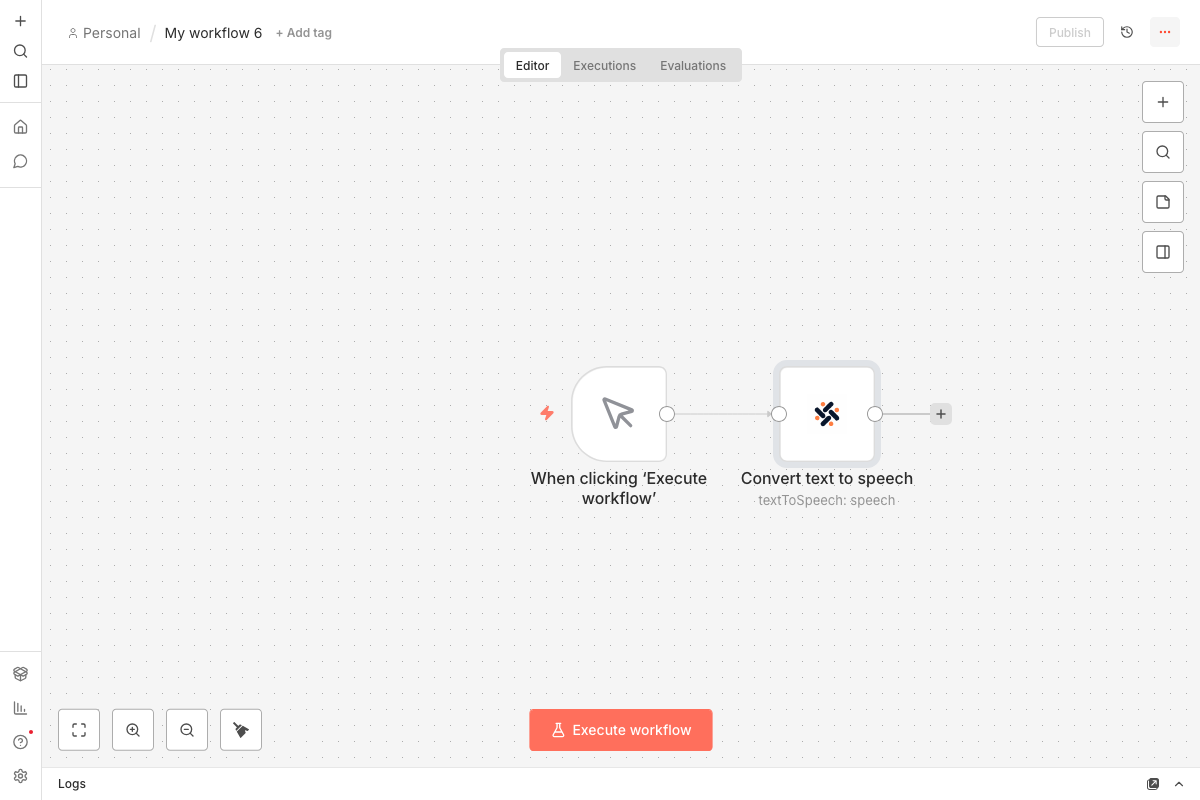 생성된 오디오는 `data`라는 이름의 바이너리 파일로 나타납니다. 저장, 이메일 전송, 어디든 보낼 수 있습니다!
---
## 완벽한 음성 찾기
### 모든 보이스 둘러보기
1. Typecast 노드 추가
2. **Resource** → `Voice` 설정
3. **Operation** → `Get All Voices` 설정
4. 노드를 실행하여 사용 가능한 모든 음성 확인
### 음성 추천
1. Typecast 노드 추가
2. **Resource** → `Voice` 설정
3. **Operation** → `Recommend Voices` 설정
4. 텍스트 설명을 입력하고 노드 실행
추천 결과에는 `voice_id`, `voice_name`, `score`만 포함됩니다. 합성 전에 지원 모델, 감정, 성별, 나이대, 사용 사례 같은 메타데이터가 필요하면 **Get Voice** 또는 **Get All Voices**를 사용하세요.
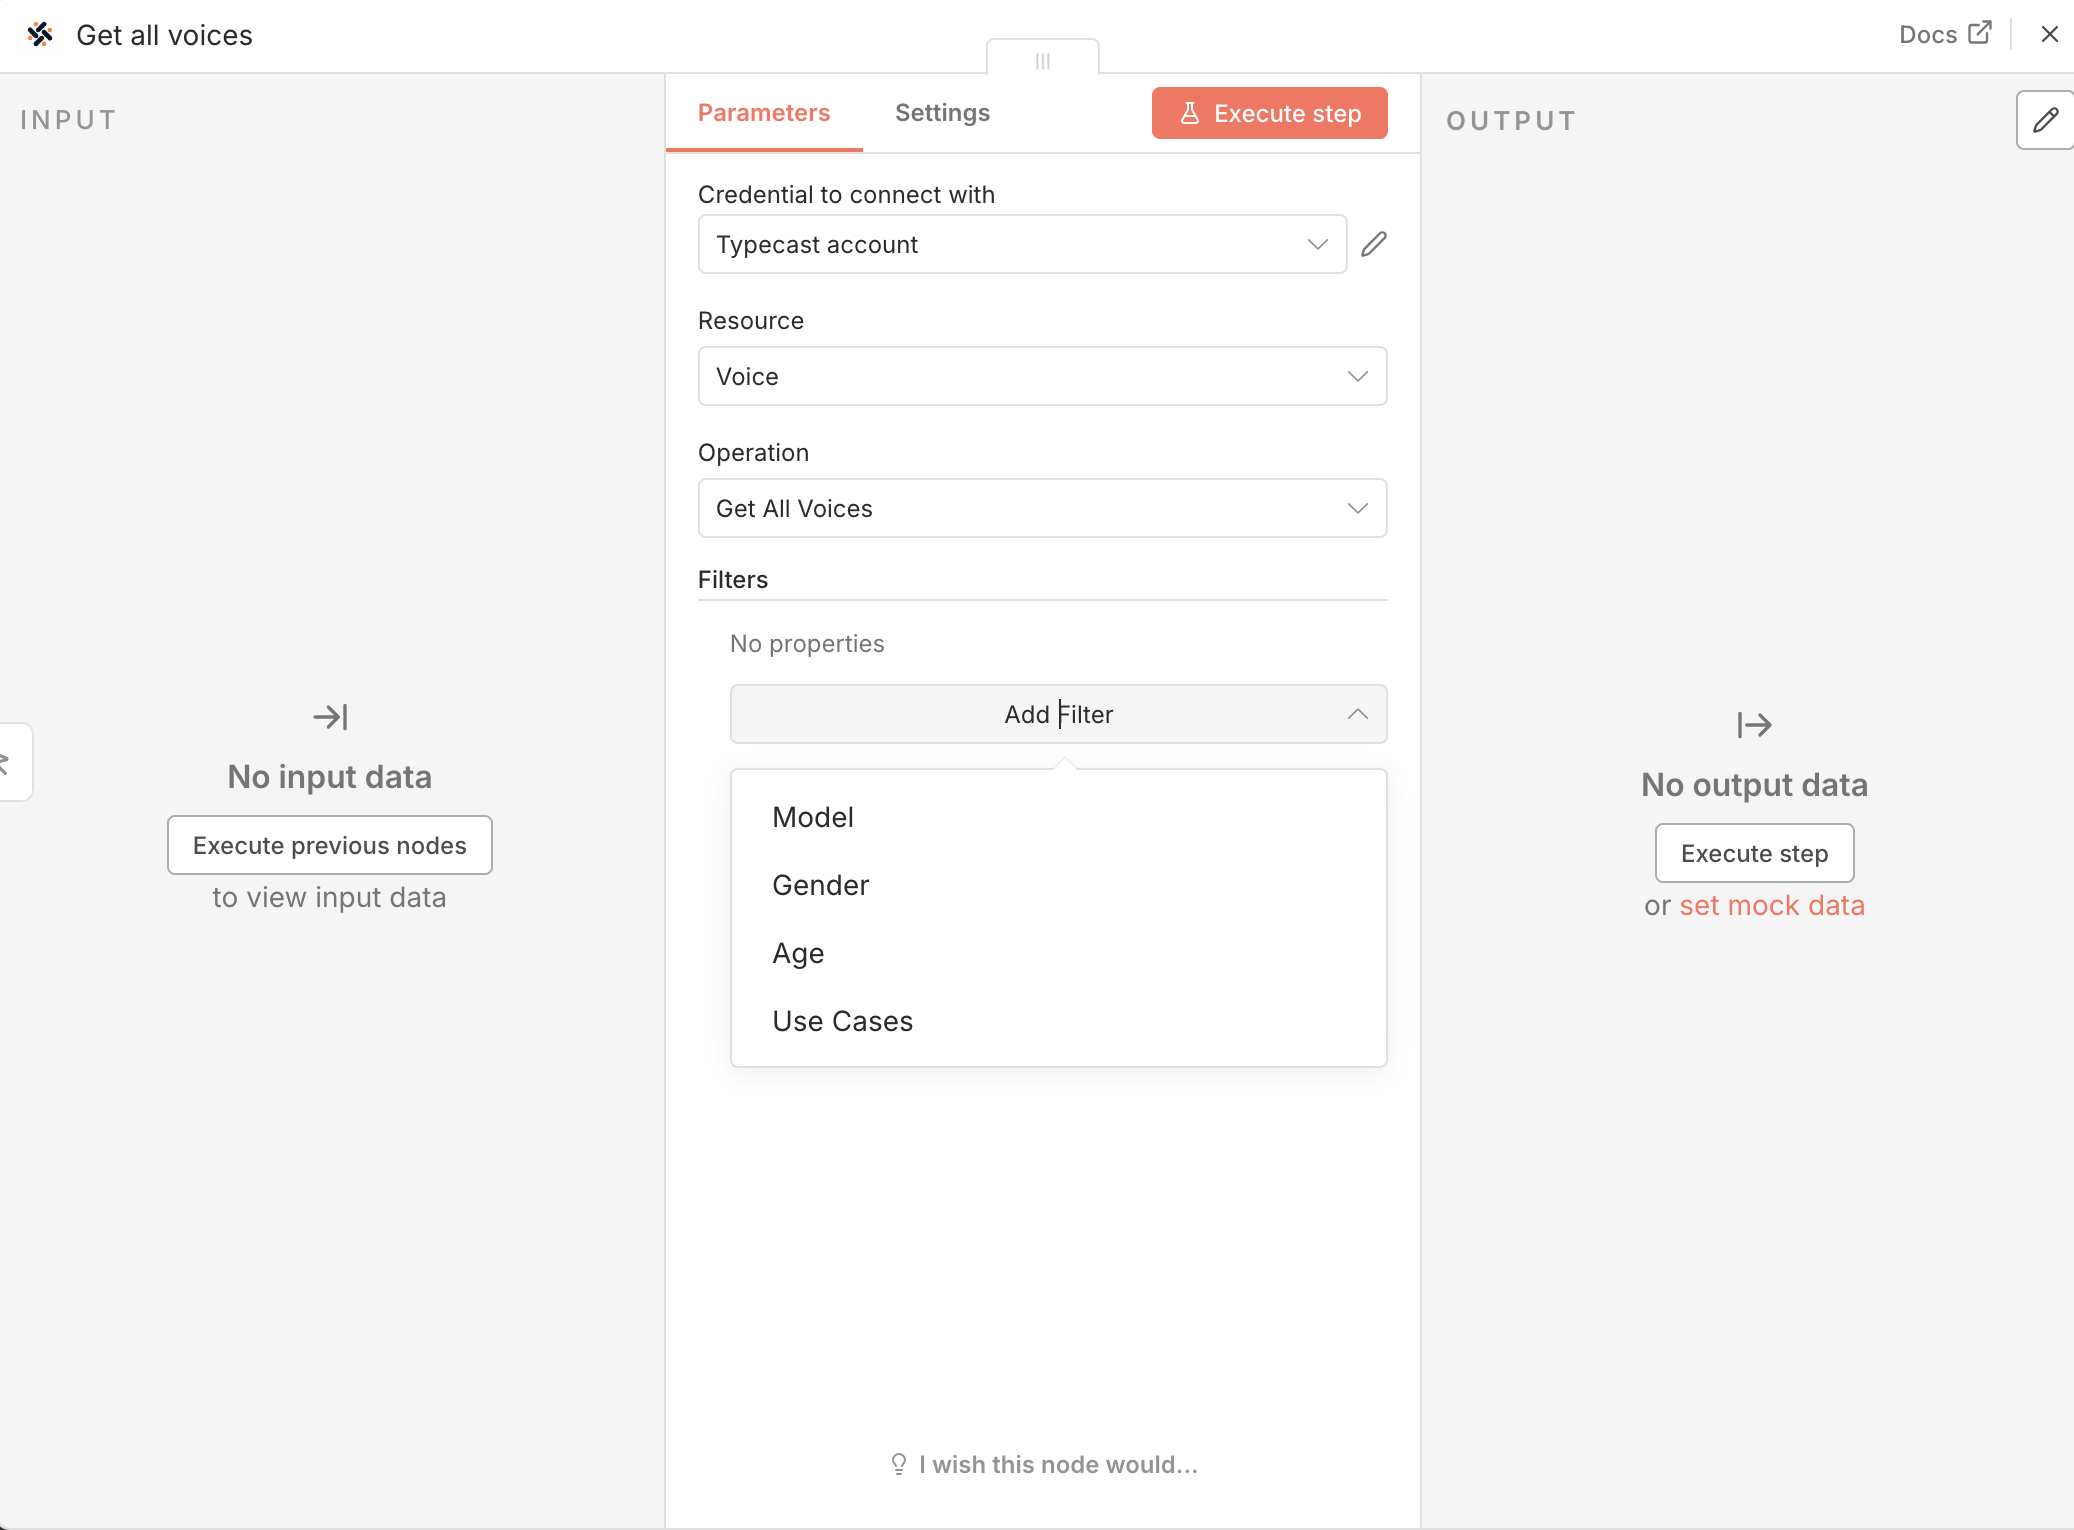
### 보이스 필터링
필터를 사용하여 원하는 것을 정확히 찾으세요:
| 필터 | 옵션 |
|--------|---------|
| **Model** | `ssfm-v30` 또는 `ssfm-v21` |
| **Gender** | `Male` 또는 `Female` |
| **Age** | `Child`, `Teenager`, `Young Adult`, `Middle Age`, `Elder` |
| **Use Cases** | `Audiobook`, `Ads`, `E-learning`, `Game`, `Podcast` 등 |
 ---
## 문제 해결
- n8n을 완전히 다시 시작하세요
- 브라우저 캐시를 지우세요
- **Settings** → **Community Nodes**에서 설치를 확인하세요
- API 키가 올바른지 확인하세요
- [타입캐스트 API 콘솔](https://studio.typecast.ai/developers/api/)에서 키를 확인하세요
- 키에 여분의 공백이 없는지 확인하세요
- **Get All Voices** 작업을 사용하여 유효한 Voice ID를 찾으세요
- Voice ID는 대소문자를 구분합니다 (소문자 `tc_...` 사용)
- 텍스트가 비어 있지 않은지 확인하세요
- API 크레딧이 충분한지 확인하세요
- 노드 출력에서 오류 메시지를 확인하세요
---
## 참고 자료
npm 레지스트리에서 보기
소스 코드 보기 및 기여하기
사용 가능한 모든 보이스 둘러보기
타입캐스트 API 탐색하기
## 무음 길이 조절
`@neosapience/n8n-nodes-typecast` **1.2.5 이상**의 음성 생성 작업에서 **Additional Options → Remaining Silence (Ms)**를 추가하세요. 추가 시 표시되는 `300`은 해당 옵션의 초기값이며, 옵션을 추가하지 않은 기존 워크플로에는 적용되지 않습니다.
`remove_silence_ms`는 제거할 시간이 아니라 **남길 무음 길이**를 지정합니다. `0`부터 `1000`ms까지의 정수를 사용하세요. `0`은 검출된 무음을 제거하며, 생략하거나 `null`을 지정하면 지정 길이에 따른 무음 제거를 적용하지 않습니다.
일반·스트리밍·타임스탬프 TTS는 `output.remove_silence_ms`, Compose는 각 `tts` 세그먼트의 `segments[].output.remove_silence_ms`로 전달합니다. 반환 타임스탬프는 처리 후 오디오를 기준으로 하며, 명시적인 `pause` 세그먼트는 유지됩니다.
스트리밍의 기본 앞부분 무음 트림은 별개입니다. 특히 `0`처럼 작은 값에서는 재생 가능한 청크 수신에 간격이 생길 수 있으므로 충분한 재생 버퍼를 확보하고 실제 콘텐츠로 확인하세요.